文章
简历是被机器先看一遍的,我做了一个工具解决这件事
上个月帮朋友改简历。她的作品不错,实习也扎实,投了五十多份,回音寥寥。
我把她的简历 PDF 拉进文本编辑器看了一眼——全文零个字符。整份文件是一张图。
也就是说,第一轮筛选时,系统读到的是一张白纸。她很认真地用设计软件排了版,双栏、色块、技能进度条,视觉上确实好看。但机器眼里,这份简历不存在。
后来我把这件事翻来覆去想了几天,干脆自己写了个工具。它现在叫简历工坊,纯网页,一个文件双击就能跑,不联网、不注册。
简历其实要被两套系统读
这是整件事的前提,也是大部分人做简历时没意识到的地方。
| 读者 | 关心什么 | 怎么读 |
|---|---|---|
| HR / 用人经理 | 三秒内判断要不要继续看 | 人眼,扫标题和最近一段经历 |
| ATS(简历筛选系统) | 关键词、公司、时间、学历 | 解析文本层,切字段 |
两套系统的要求经常互相打架。人眼喜欢双栏、色块、图标;机器讨厌所有让文本顺序错乱的东西。技能进度条尤其典型——人眼看到「React 80%」,机器看到的是 0 个字符。
所以一份简历真正要做的,是在机器能读的前提下,让人也愿意读。顺序不能反。
用 Markdown 当源文件,不是偷懒
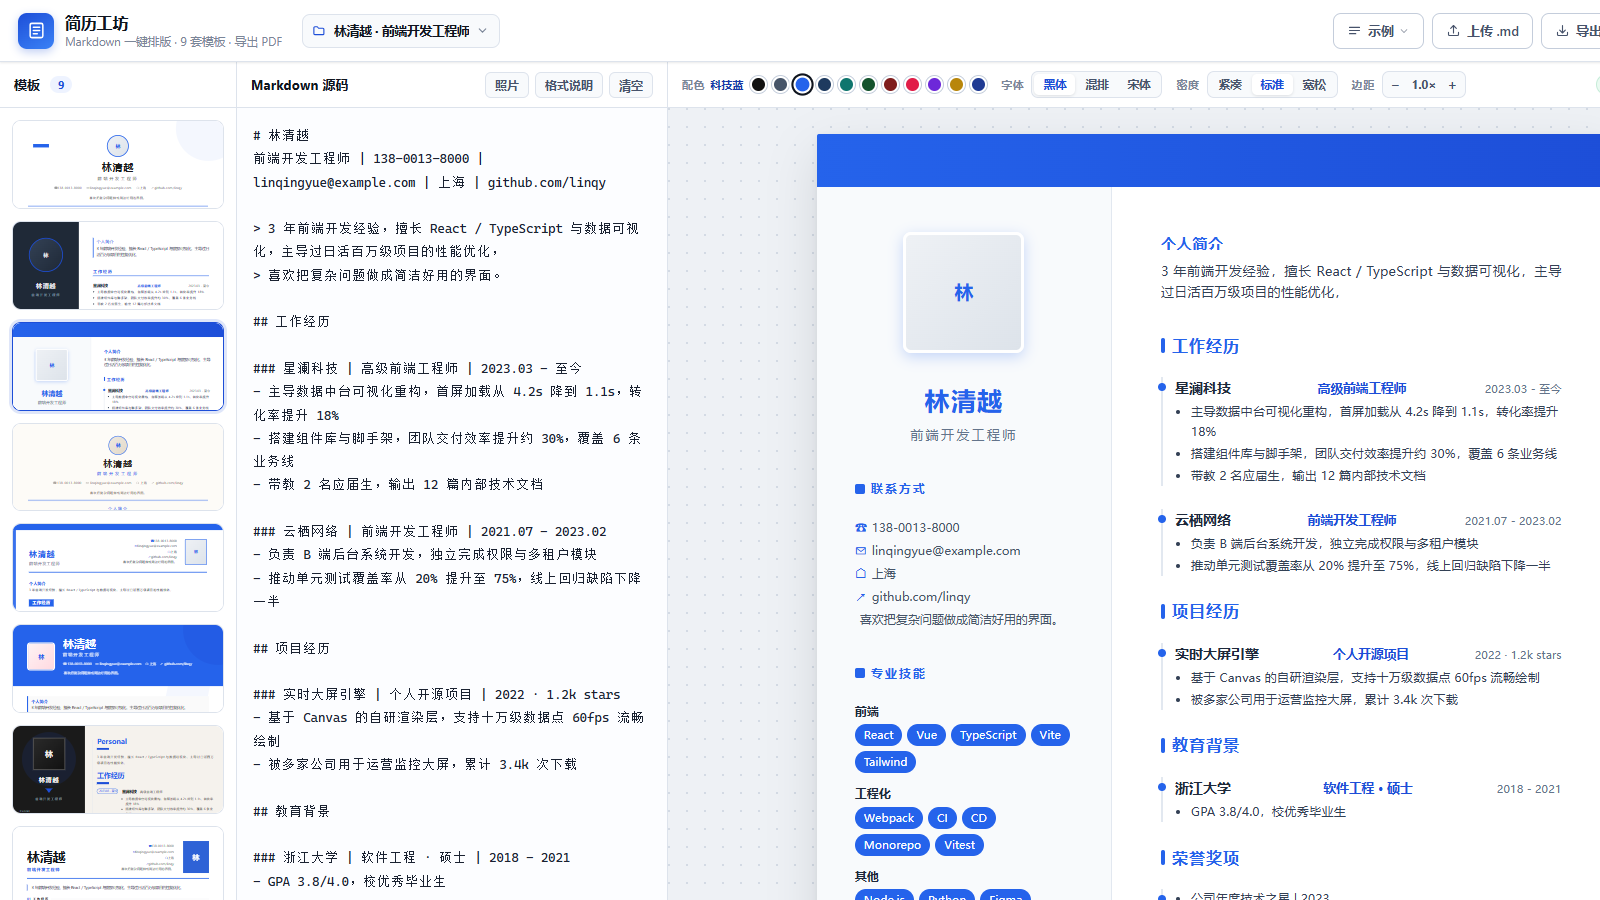
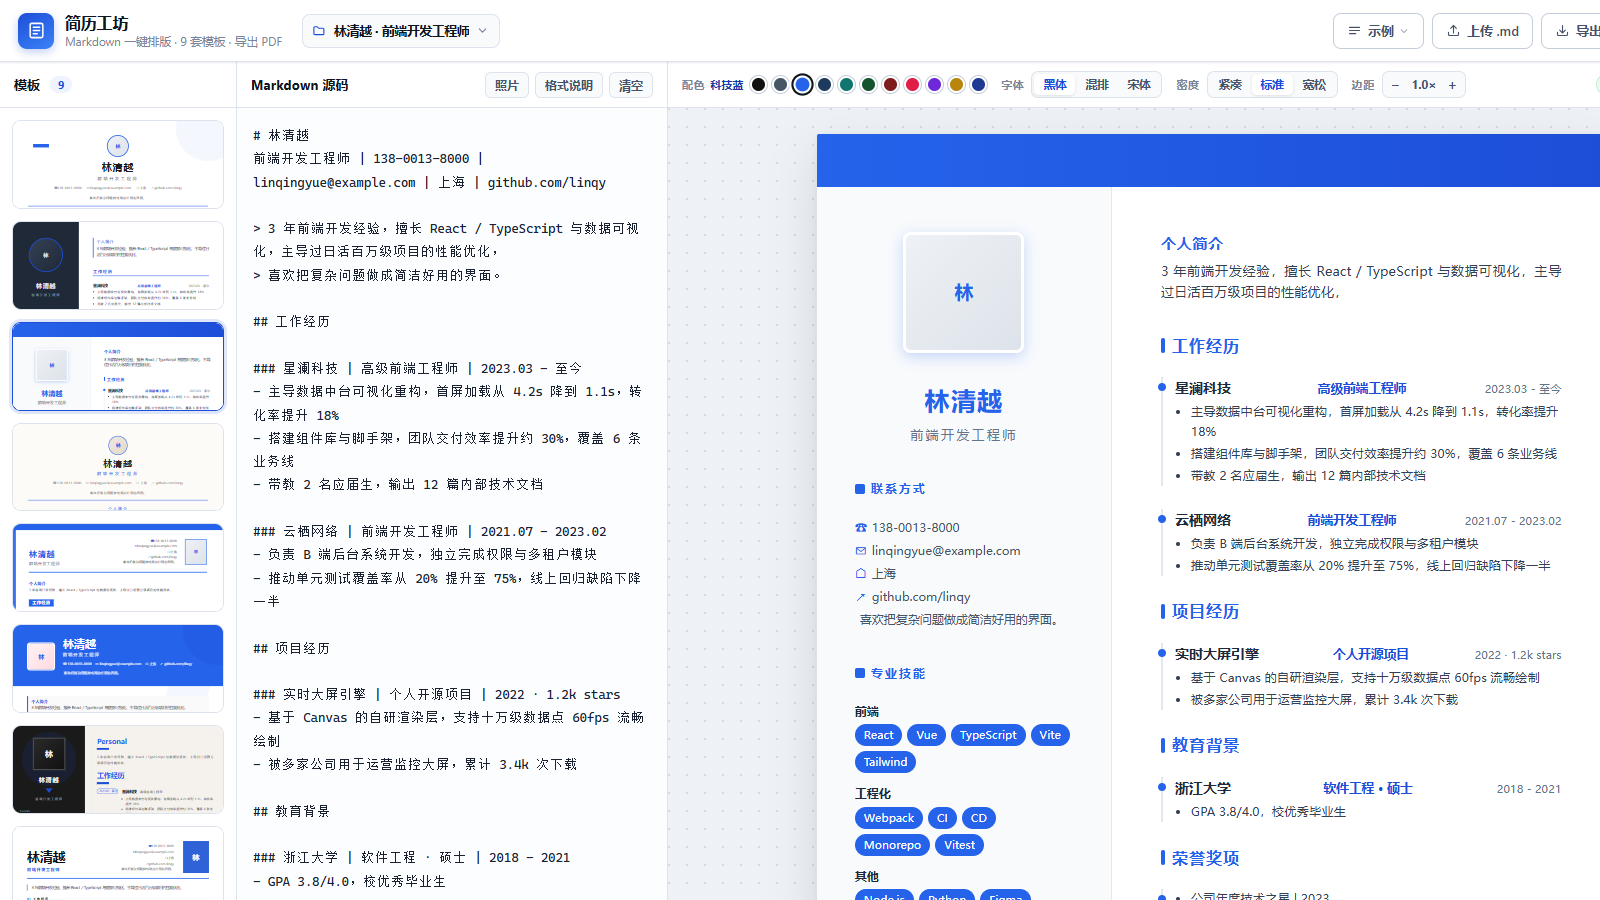
(下图是工具的工作台,从左到右:模板画廊、Markdown 原文、实时预览。)
很多在线简历工具的形态是「拖拽编辑器」:从侧边栏把「工作经历」拖进画布,填表单。
我没这么做,原因有三个。
一,内容和版式必须分开。 同一段经历,投互联网大厂和投传统制造业,措辞不一样,但排版不该重来一遍。Markdown 里只有内容,版式是渲染时才套上去的——换模板只换皮,不动一个字。
二,纯文本可以被 diff。 简历改到第十版的时候,你会想知道「上一版到底删了什么」。Markdown 能进 Git,能对比,能回滚。拖拽编辑器的存储格式做不到这一点。
三,纯文本可以被复制和复用。 简历里最值钱的是那些成果描述。它们应该能直接粘到求职邮件、内推话术、面试自述里,而不是锁在一个富文本编辑器里。
工具里保留的 Markdown 写法很少,够用就行:
# 姓名

求职意向:前端开发工程师

## 工作经历

### 公司名 | 职位 | 2023.03 - 至今
- 主导数据中台可视化重构,首屏加载从 4.2s 压到 1.1s,转化率提升 18%
- 搭建组件库与脚手架,团队交付效率提升约 30%,覆盖 6 条业务线
# 是姓名,## 是板块,### 是「公司 | 职位 | 时间」,- 是成果要点。解析器写得比较宽容,2023-03、2023.03、2023 年 3 月 都能认出来,中英文板块标题会按语义归类,不要求你背模板。
一页纸是硬约束,所以页数必须实时可见
应届生一页,资深最多两页——这条规矩没有例外,而且违反它的代价被严重低估了。HR 翻第二页的概率,比你想的低得多。
所以工具里页数是实时算的。右上角有个页数徽标,超了会变红,点开能看到每个板块吃了多少毫米。
真正麻烦的是「差一点点排不进去」。差 8mm,删掉一条还不错的成果,心疼;加行距又更好看,但直接溢出到第二页。
这里有个很多人会踩的坑:不要用自动缩放去硬塞。把字号从 10.5pt 缩到 9.5pt,看起来只是小了一点,实际上整个视觉层级全塌了——正文和辅助信息区分不开,行距被压缩到呼吸不畅,打印出来一眼就显得局促。
我给的是两个物理调节项:
- 密度:紧凑 / 标准 / 宽松,作用于板块间距,不动字号。
- 版心:0.6× 到 1.4×,等比缩放纸边留白,边调边看页数。
等比缩放而不是直接给毫米值,是因为双栏模板的左右留白本来就不对称(侧栏窄、主栏宽),统一成同一个值会破坏版式平衡。缩放系数保住了这个相对关系。
代价是:真到极限的时候,还是得删内容。工具只能告诉你「删掉这段就够了」,不能替你把话说短。
内容体检:不给「建议优化」这种废话
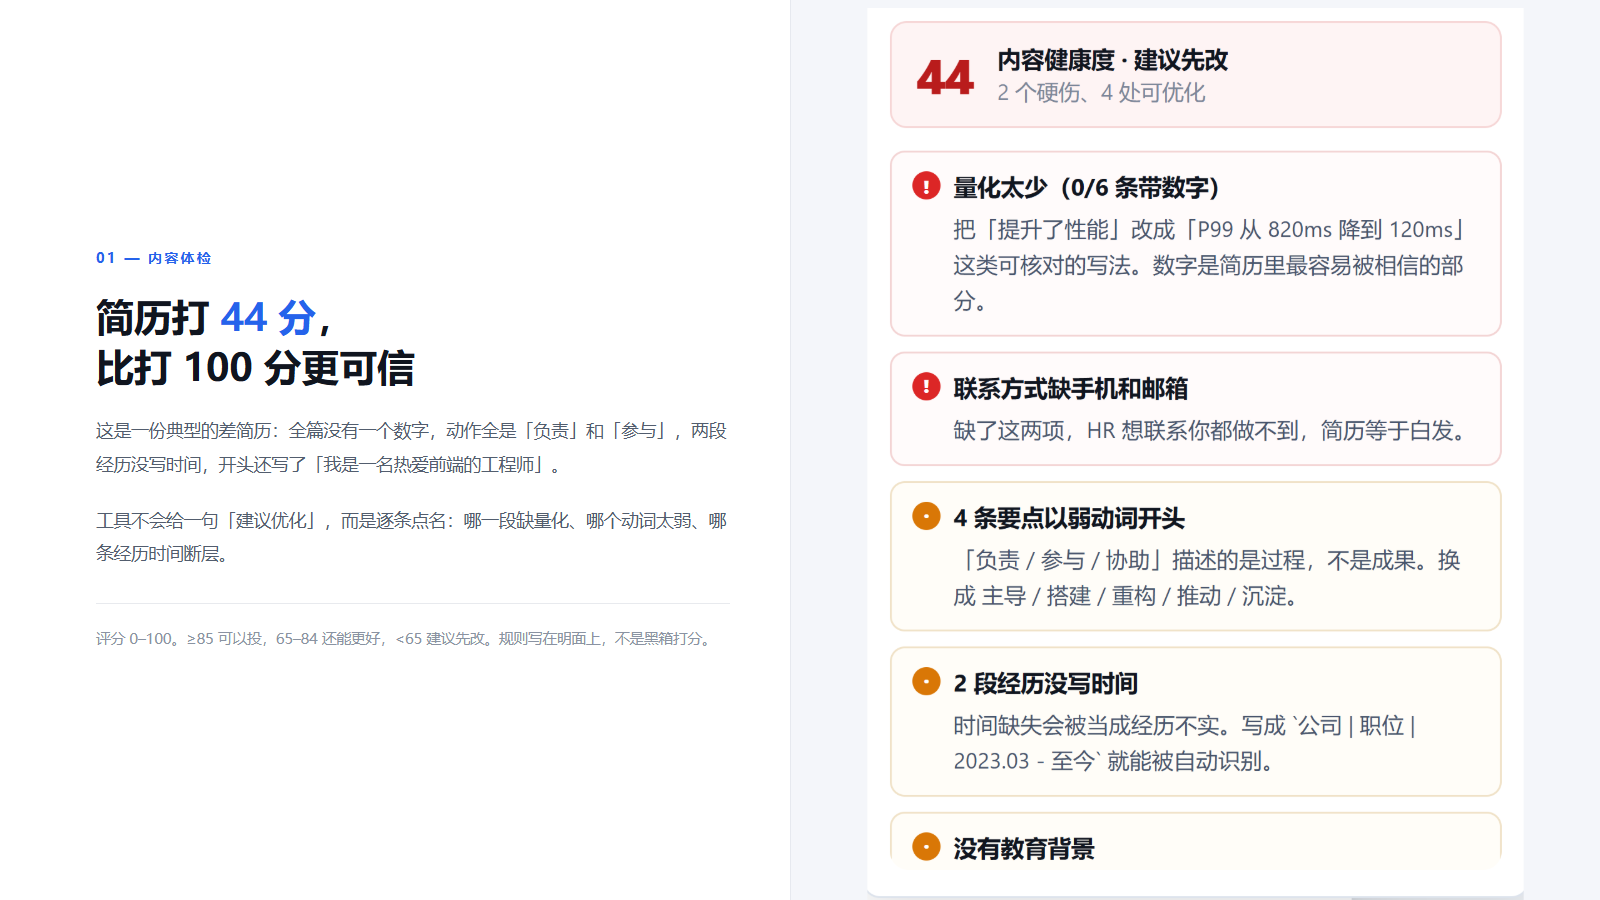
上面这份是我故意写的「典型差简历」:全篇没有一个数字,动作全是「负责」和「参与」,两段经历没写时间,开头写「我是一名热爱前端的工程师」。
它被打 44 分,「2 个硬伤、4 处可优化」,六条问题逐条点名:
- 量化太少(0/6 条带数字)——并且给出改法示例:「提升了性能」改成「P99 从 820ms 降到 120ms」
- 联系方式缺手机和邮箱
- 4 条要点以弱动词开头——「负责 / 参与 / 协助」描述的是过程,不是成果
- 2 段经历没写时间——时间缺失会被当成经历不实
- 没有教育背景
- 没有技能板块——招聘系统靠技能关键词做初筛,缺这块会直接丢掉岗位匹配
评分的价值不在于那个数字,而在于每一条扣分都能落到某一句话上。规则一共十一条,全部写在明面上:量化率、弱动词、单条要点、时间缺失、人称代词、超长句、板块完整度(经历 / 教育 / 技能 / 简介)、联系方式。
有意思的是,我给内置示例简历打的是 100 分。很多人第一次打开看到 100 分,会觉得这工具没东西可挑。但换个角度:如果连示例都过不了,说明规则本身有问题。
岗位匹配:同义词在机器眼里不是同一个词
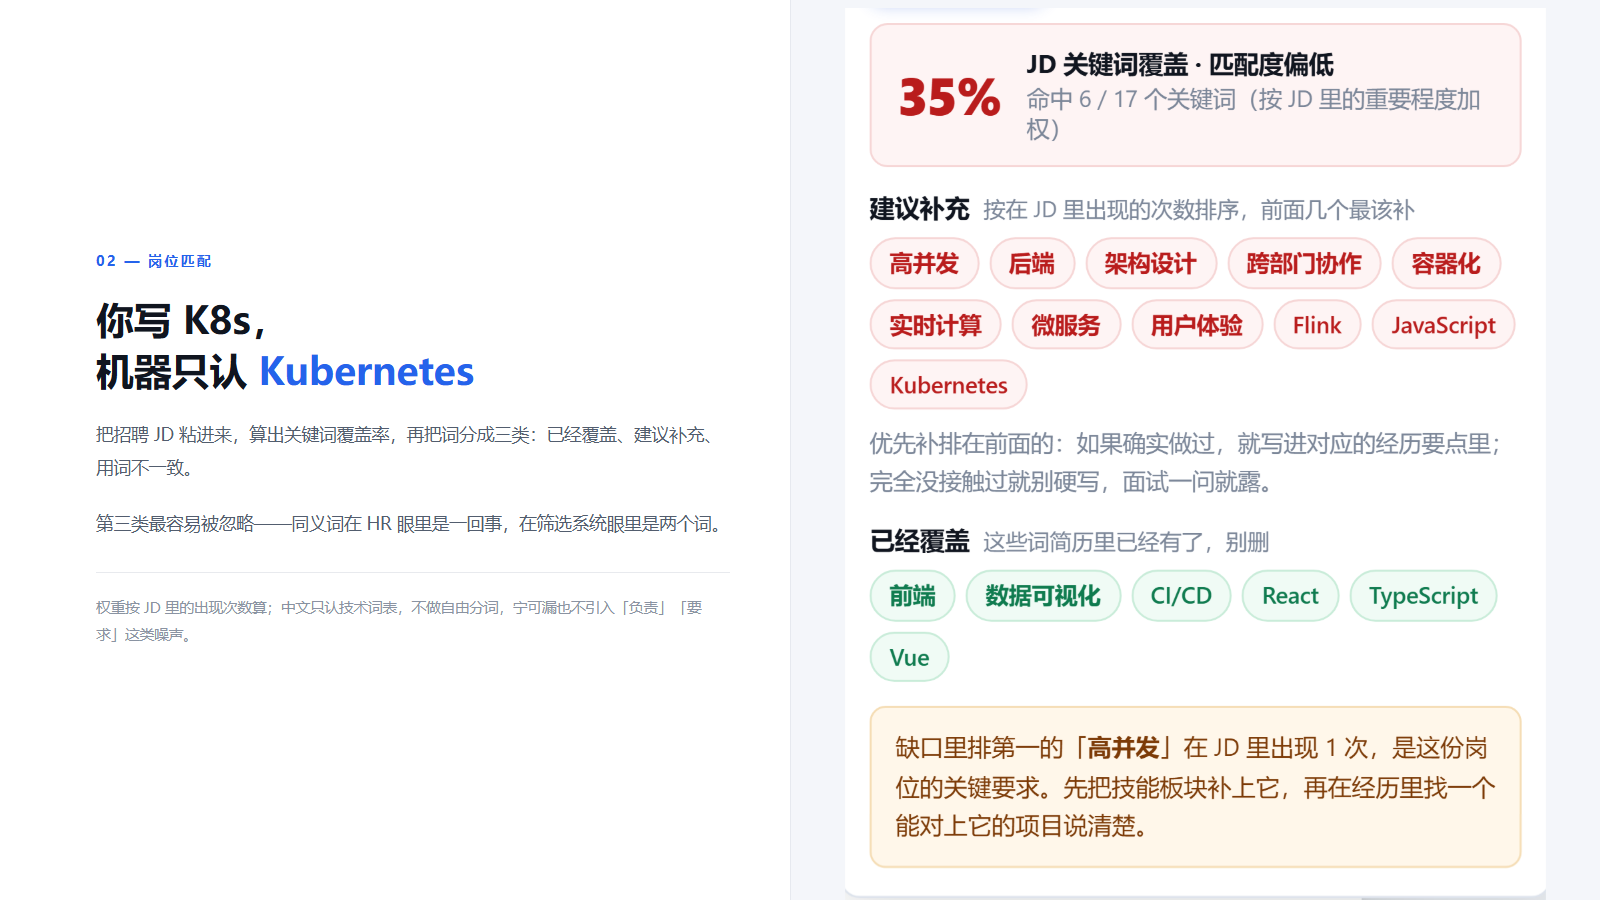
这是我认为最该有、但大部分简历工具都没有的功能。
把招聘 JD 粘进去,工具算出关键词覆盖率,然后分成三组:
- 建议补充(红):JD 里反复出现,你简历里没有的词
- 用词不一致(黄):意思对上了,但写法不一样
- 已经覆盖(绿):两边都有
第三组之外,最容易吃亏的是第二组。你写 K8s,JD 写 Kubernetes;你写 React Hooks,JD 只认 React。在 HR 眼里这是一回事,在字符串匹配眼里这是两个词。
所以词表里带了同义词归一:k8s ↔ kubernetes、ci/cd ↔ 持续集成、前端 ↔ frontend / 前端开发 之类,一共 35 组。命中任一写法都算覆盖,但会提示你「简历里建议用 JD 的原词」。
算法上有两个刻意的保守选择:
中文不做自由分词。 中文分词在这类文本上会切出大量噪声——「负责」「要求」「具备」「良好的」全会被当成关键词,最后覆盖率虚高、建议全是废话。所以中文只认一份约 140 个词的技术职能词表,宁可漏掉冷门词,也不污染结果。
英文按词边界提任意 token。 技术名词的长尾太多了,Flink、ClickHouse、ProtoBuf 这种词不可能预先穷举。按词边界提出来,再用停用词过滤掉 team、experience 这类套话。
权重按 JD 里出现的次数算(封顶 4),所以出现三次的「高并发」会排在只出现一次的词前面。
坦白讲,这套东西对英文技术岗最准,对传统行业、医疗、制造的 JD 会偏保守——词表是手写的,覆盖不到的地方就漏了。
为什么不在前端直接生成 PDF
技术上完全做得到:引入 jsPDF 和 html2canvas,点一下就下载。我没做,原因很明确。
html2canvas 的原理是把 DOM 截图再塞进 PDF。结果是:文字变成图像,不可选中、不可搜索、没有文本层。
这等于把这个工具存在的意义给删了——你辛辛苦苦过了一遍关键词匹配,最后导出的是张图,ATS 还是读不出来。
走浏览器打印就不一样了。Chrome 打印出来的是矢量 PDF,文字保留文本层,链接可点,是真正的「文档」而不是「图片」。
代价是必须把用户引导对:关掉页眉页脚、边距设成「无」、勾上背景图形。这三项任何一个没设对,打出来要么多一行网址、要么白底变灰、要么纸张宽度被边距挤窄导致分页错乱。所以导出时会给一个三步引导,而不是直接甩出系统打印框。
顺便说个实现细节:里面所有模板的纸张宽度都锁死在 210mm,打印时也不允许用 width: auto。宽度一旦跟着浏览器边距漂移,分页就会错位——这是我在调试多套模板多出空白页时踩了最久的一个坑。
数据只放在你自己的浏览器里
简历里全是手机号、住址、上家公司。这种东西不该上传到别人的服务器上,尤其是免费工具。
所以整站没有后端。内容存在 localStorage,关掉页面还在,清理缓存就没了——这是本地存储的代价,所以配了三个出口:
- 历史快照:停手几秒自动存一版,最多 12 版,随时回滚
- 整库备份:导出
.json,含照片、模板、配色、每份的 JD 和历史版本;恢复时按 ID 非破坏合并,同 ID 取更新时间较新的 - 分享链接:内容用
CompressionStream压成 deflate-raw,base64url 编码塞进 URL 的 hash。链接给谁,谁就能打开看,全程不经过任何服务器
第三项在 file:// 打开时会降级——浏览器不允许在本地协议下用某些 API,这时会提示改成导出单文件 HTML。
已知的局限
写清楚比藏着好:
- 模板只有 9 套,双栏的上限就是这里了。复杂版式(时间轴、图形化、杂志风)没做,因为它们在 ATS 里的表现普遍更差,做了反而误导人。
- 没有拖拽排版。顺序只能靠调整 Markdown 里的板块顺序。这是有意的——拖拽必然带来绝对定位,绝对定位必然破坏文本流。
- 中文词表是手写的。冷门岗位的匹配率会偏低,扩词表要直接改源码里的数组。
- 不支持多页优化。超页只提示,不会自动分页到第二页做得更好看。理由还是那条:一页纸优先。
- 照片只是占位。上传后按固定尺寸裁切,不提供人脸对齐、背景去除。
怎么用
打开 index.html 就行,双击本地文件也可以,不需要装任何东西。
一个典型的使用顺序是:
- 把现有简历的文字粘进中间栏(或者按上面的格式手写一遍,多数人会发现原来的表述里有大量「负责」)
- 右边挑一个模板,看着预览选配色
- 点页数徽标看体检,先把 44 分那些硬伤改掉
- 找到目标岗位的 JD,粘进「岗位匹配」,把红色和黄色的词补上
- 再回来看页数,超了就调密度和版心,还超就删内容
- 导出 PDF,文件名自己定,比如「张伟-字节-前端-2026.10」
最后一步的文件名不是小事。HR 下载一堆 简历.pdf、简历(1).pdf、未命名.pdf 的时候,一个写清楚姓名和岗位的文件名,是你唯一能控制的印象分。
工具是给自己用的,所以每个功能都对应一个具体的不爽时刻。如果你用下来觉得哪个环节还是别扭,那种「又要手动搞一下」的地方,大概就是我下一个该修的东西。