文章
python重量级爬虫框架scrapy
分类:python
标签:scrapy
提起爬虫,大家一定会想到python,想到python,一定会想到scrapy,可以说不会scrapy,你就是没有掌握爬虫,没有体会到爬虫的精髓。
首先介绍下如何安装,基本上我们在有了pip包管理工具之后,我们基本都使用pip来安装第三方库。 pip install scrapy
安装好后,我们就可以使用pip命令,命令行输入pip就可以查看它的使用方式。
通过scrapy fetch url就可以进行基本的抓取查询
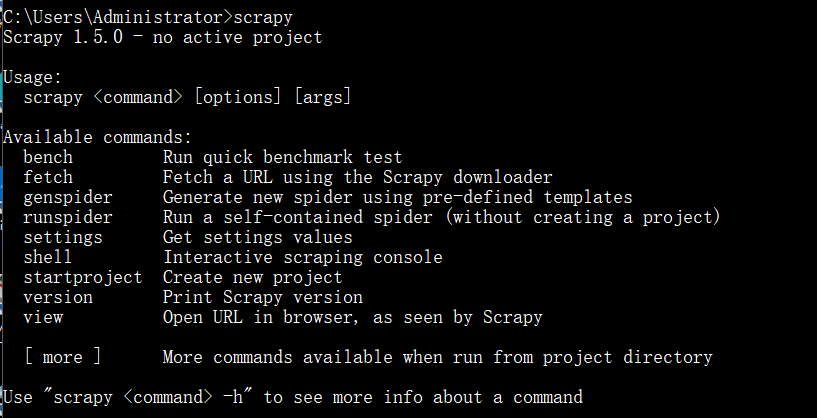
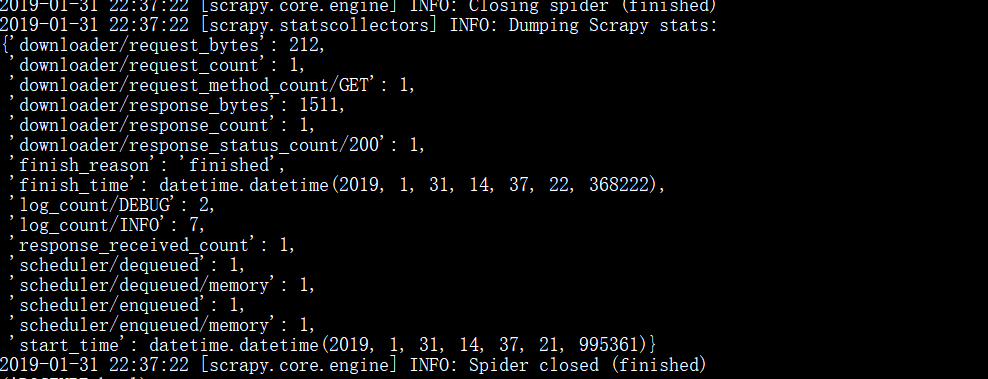
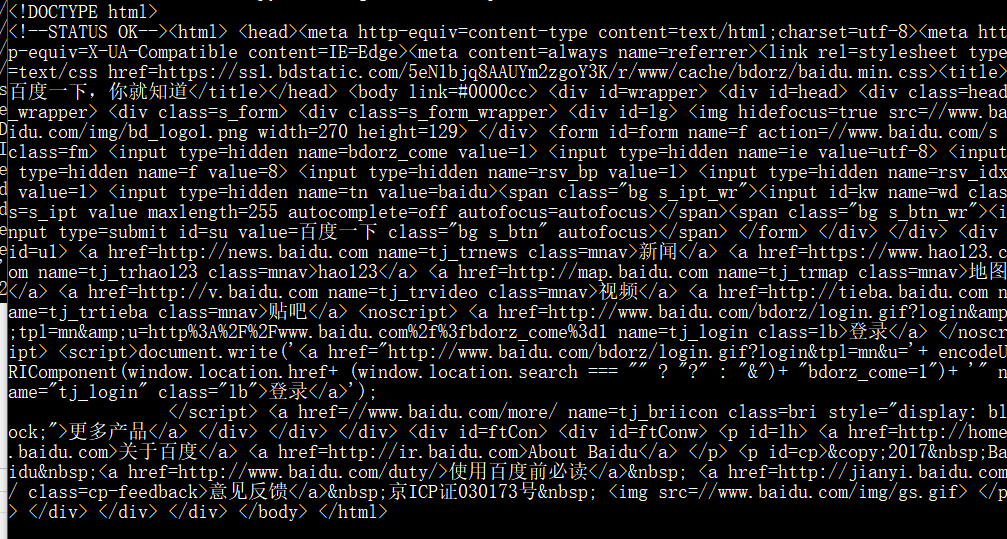
这里我们可以看到网页的基本信息,网页源代码。
当然,我们还可以测试一些匹配规则,进行验证,比如,我们获取下底部的关于百度链接。这个就是通过scrapy shell 进行分析,比如scrapy shell https://www.baidu.com/
然后我们输入response就可以看到相应结果,<200 [](https://www.baidu.com>” _src=”https://www.baidu.com>”>https://www.baidu.com>]
比如我们要获取网页的title